一直有个心病:模型说得特别笃定,但你也不知道它是真懂还是在编。人工核对又太费时间,尤其是那种表面看不出对错的结论。 最近试了个技能,装上之后可以在主力工具里把一段输出丢给另外两家模型交叉打分。一个偏推理,一个偏中文长文本,让它们各自判断结论…
按最新统计,上周(11月9日至15日)全球AI大模型总调用量约211万亿Token,环比涨了0.48%中国模型合计119.1万亿Token,环比增长2.51%。美国模型是14.83万亿Token,涨幅6.08%。#开源项目 全球调用量前五里…
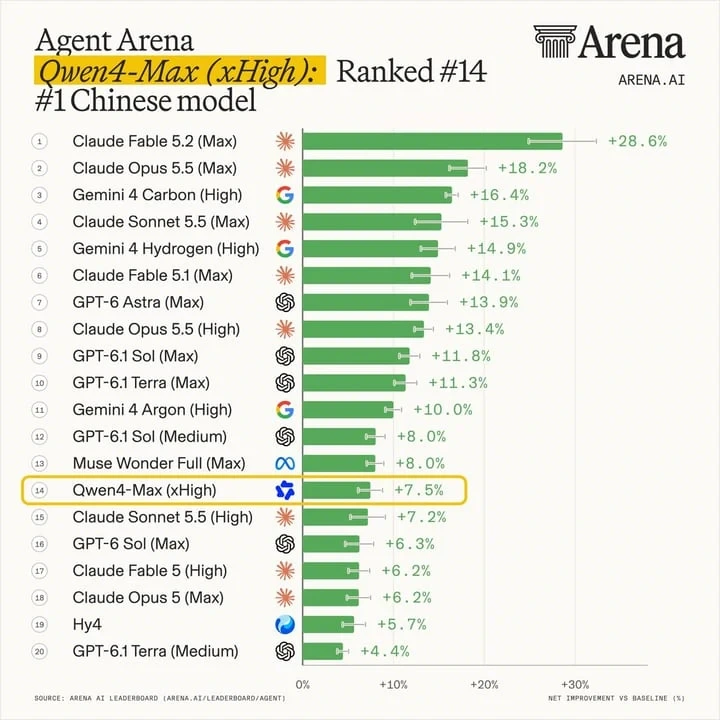
Qwen4-Max在Agent Arena总榜拿到第14名,净提升达到+7.5%,还成了排名最高的中国模型。 这个结果也把Alibaba推到中国实验室第一、总榜第五,前面只剩Anthropic、Google、OpenAI和Meta。 单看这…