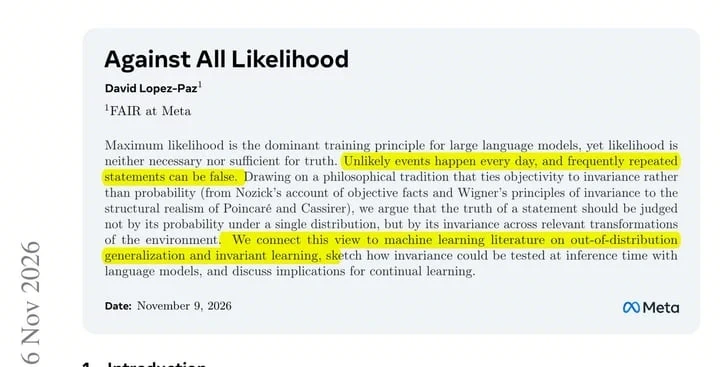
Meta 这篇论文把矛头指向了一个常用判断:LLM 的似然高,不代表答案就是真的。 模型可能只是记住了文本里常见的说法。 论文建议换几个视角作答,比如让 3 位医学专家分别回答,只保留共同部分,意见对不上就先弃答。 问题是它没做实验,只有示…
#AI编程 现在还在用 command go,几个账号轮着跑。简单任务还行,遇到难一点的就切中转的 Claude。想换个便宜点的方案,看看大家现在都怎么用。
谷歌周四发布了 Gemini 4 Hydrogen。和 Gemini 3.8 Flash 放在默认高推理档位对比,完成任务的速度快了 2.5 倍,Terminal-Bench 4.1 得分也从 18.2% 提到 57%,虚构陈述少了不少。 …