派友PVQ
2小时前
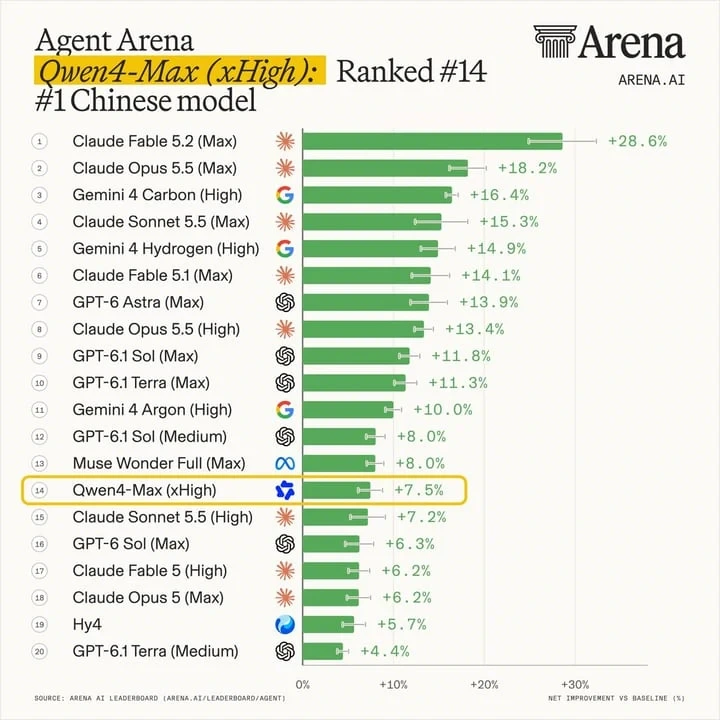
Qwen4-Max在Agent Arena总榜拿到第14名,净提升达到+7.5%,还成了排名最高的中国模型。 这个结果也把Alibaba推到中国实验室第一、总榜第五,前面只剩Anthropic、Google、OpenAI和Meta。 单看这…
大模型能力对比与选型参考
Qwen4-Max在Agent Arena总榜拿到第14名,净提升达到+7.5%,还成了排名最高的中国模型。 这个结果也把Alibaba推到中国实验室第一、总榜第五,前面只剩Anthropic、Google、OpenAI和Meta。 单看这…
一直有个心病:模型说得特别笃定,但你也不知道它是真懂还是在编。人工核对又太费时间,尤其是那种表面看不出对错的结论。 最近试了个技能,装上之后可以在主力工具里把一段输出丢给另外两家模型交叉打分。一个偏推理,一个偏中文长文本,让它们各自判断结论…
今年拿了数学界最高荣誉之一的那位学者,宣布加入一家 AI 公司做安全研究,公司几位高层也陆续确认了 这事有意思的地方不只在新闻本身。前几年这类岗位主要抢工程人才,现在开始把纯数学背景的顶尖人物请进来,多少说明有些卡点靠堆工程不一定能解决,可…
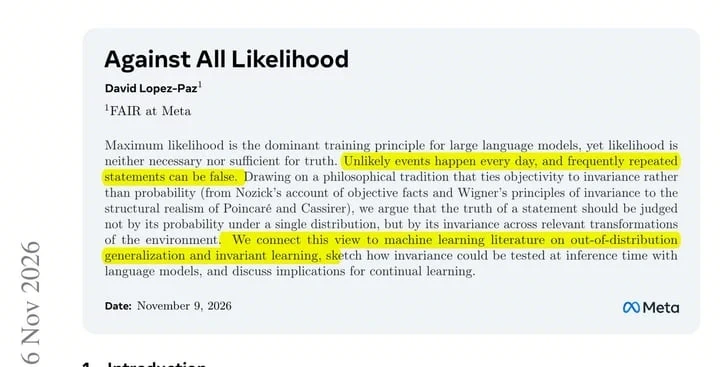
Meta 这篇论文把矛头指向了一个常用判断:LLM 的似然高,不代表答案就是真的。 模型可能只是记住了文本里常见的说法。 论文建议换几个视角作答,比如让 3 位医学专家分别回答,只保留共同部分,意见对不上就先弃答。 问题是它没做实验,只有示…
刚看到 Grok Bot 1.0 正式发布。类同事的协作智能体现在不算新鲜了,但宣传视频里这版的语音交流还是挺自然,写东西也不像那种一眼机器味的模板。xAI 在今年 8 月 11 日先放了 Grok Bot beta,定位是能交付真实工作的…
谷歌周四发布了 Gemini 4 Hydrogen。和 Gemini 3.8 Flash 放在默认高推理档位对比,完成任务的速度快了 2.5 倍,Terminal-Bench 4.1 得分也从 18.2% 提到 57%,虚构陈述少了不少。 …
豆包工作现在能直接选 Kimi 3.1 Pro、GLM 5.3、DeepSeek V4.1 Flash 这些第三方模型了,按不同工作需求切换就行。豆包 2.1 Lite 和 DeepSeek V4.1 Flash 还在做限时优惠,额度消耗倍…
Responses API 返回 failed [credit_balance_exhausted]:You have no credits remaining. Add credits to continue using the API。…
11月11日,智谱、MiniMax、千问办公、阿里云、Qoder都在电商活动页做了5折 Token。MiniMax的三款月卡全部半价,阿里云 Token Plan 两款月卡5折起,智谱周卡也是5折起。正好要续费的话,这波价格确实低。#AI产…
#AI模型 ChatGPT Work 突然不能开新聊天了,发送按钮一直是灰色的,按回车也没反应,历史对话还能正常接着用。 我按时间顺序试了一遍: 1. 重启应用和电脑 2. 网页云端 ChatGPT Work 可以正常用 3. 重置 Cha…
有消息称,日本人工智能实验室 Sakana AI 最早可能在 2027 年秋季进行 IPO。如果进展顺利,它或许会成为日本首家上市的 GenAI 开发企业,也可能创下日本初创企业 IPO 规模纪录。 Sakana AI 计划把募集到的资金投…